كيف يميز Git بين الـ Objects؟
في الدرس السابق خزنا محتوى hello.txt داخل Blob. أعاد Git قيمة طويلة استخدمناها مع git cat-file لقراءة المحتوى. لماذا كانت هذه القيمة كافية للوصول إلى الـ Blob؟
عندما يخزن Git Object فإنه يحسب قيمة اعتمادا على نوعه و حجم بياناته و محتواه. تسمى هذه القيمة Hash. يستخدمها Git كمعرف للـ Object.
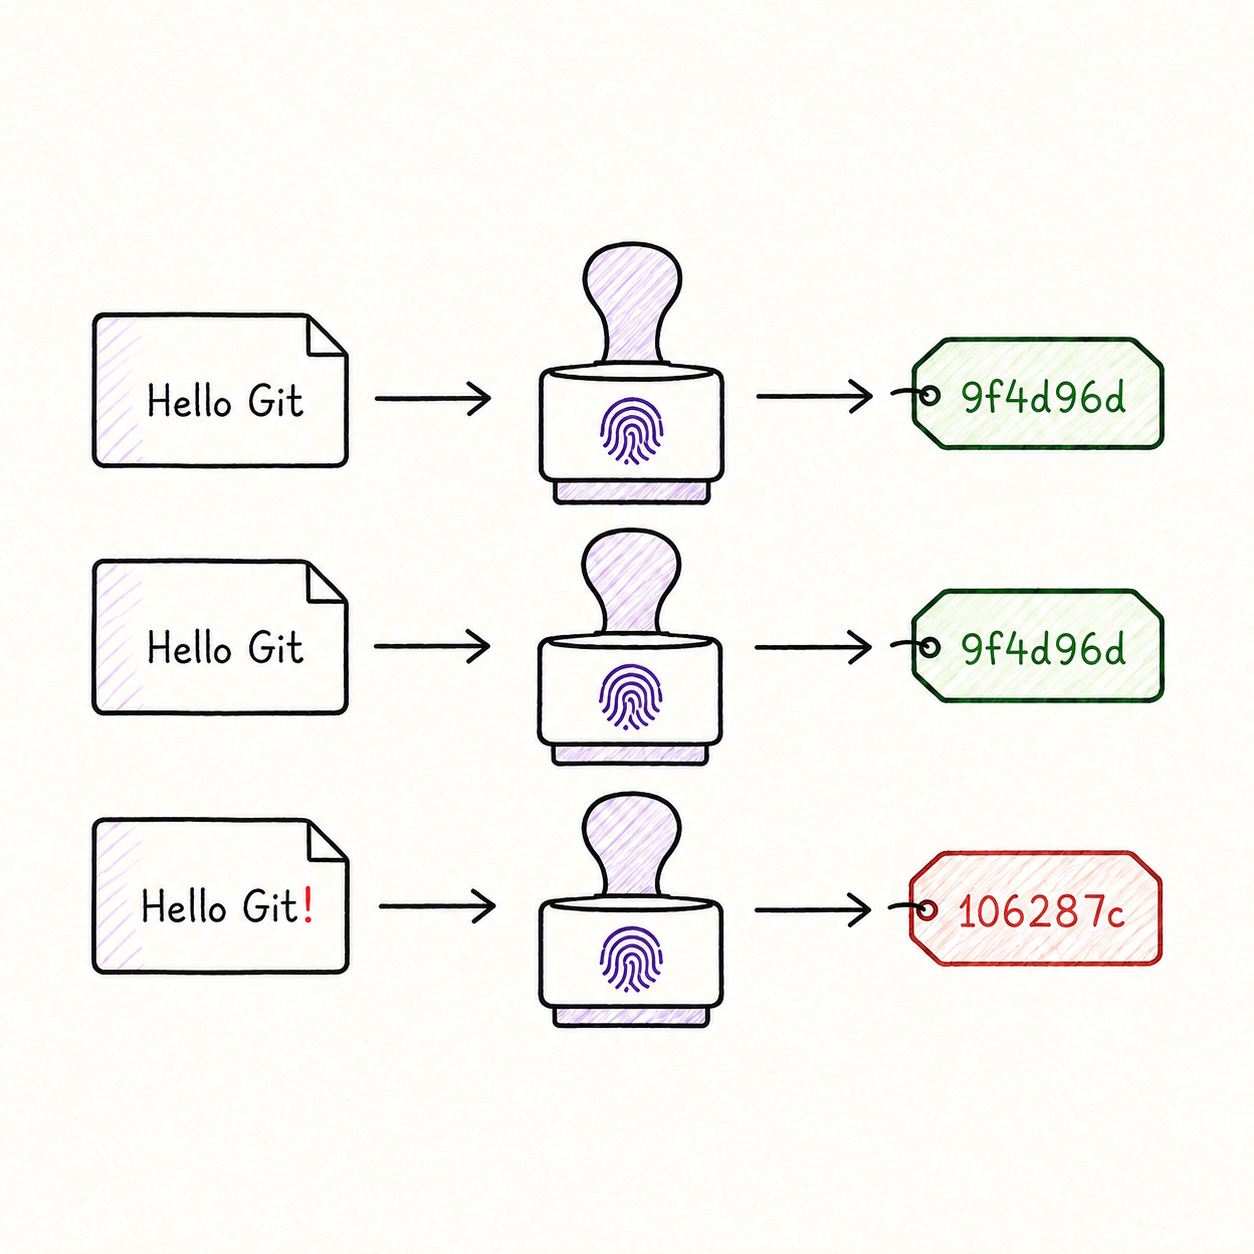
متى يتكرر المعرف نفسه؟
إذا تطابق نوع الـ Object و بياناته فإن Git يعيد الـ Hash نفسه. رأينا ذلك في الدرس السابق مع هذا المحتوى:
Hello Gitكان معرف الـ Blob:
9f4d96d5b00d98959ea9960f069585ce42b1349aلو طلبنا تخزين Blob آخر بالبيانات نفسها فسيعيد Git هذا المعرف نفسه. أما تغيير المحتوى فينتج عنه معرف آخر في الاستخدام المعتاد:
Hello Git   → 9f4d96d
Hello Git   → 9f4d96d

Hello Git!  → 106287c
لهذا لا يحتاج Git إلى تخزين نسختين من الـ Blob نفسه. المعرف نفسه يقوده إلى البيانات نفسها.
كيف يصبح المحتوى عنوانا؟ (Content Addressing)
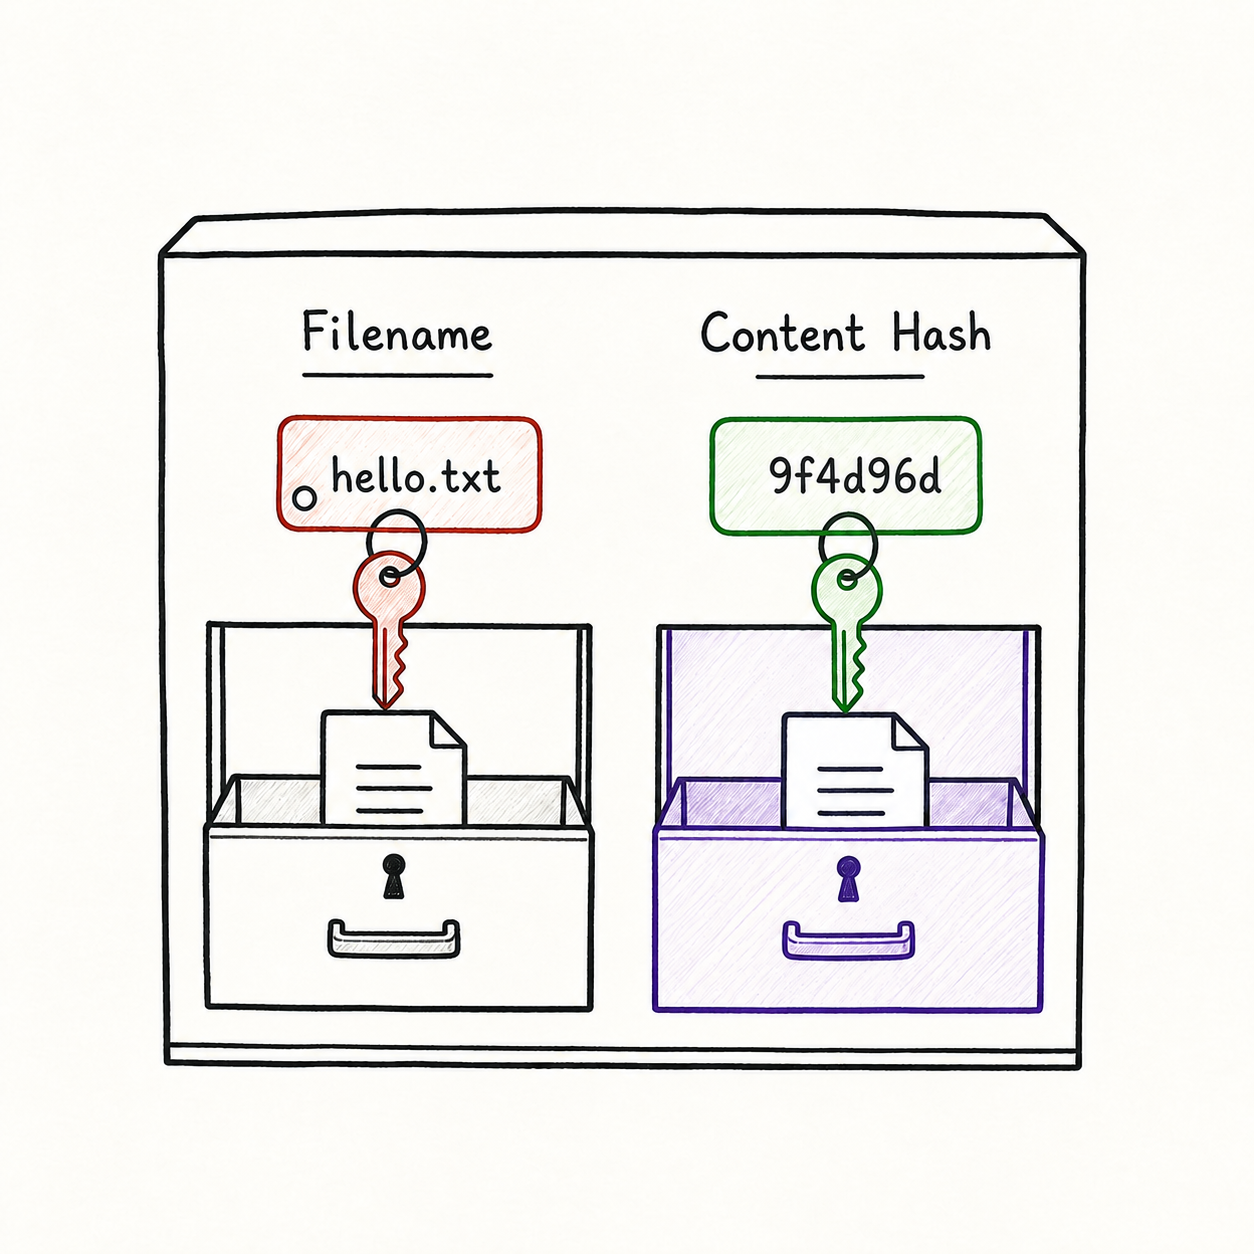
في الـ Working Directory نصل إلى الملف عبر اسمه و مساره:
notes.txt
image.png
report.pdf
أما داخل الـ Object Database فيصل Git إلى الـ Object عبر الـ Hash. لا يستخدم اسم hello.txt لأن الاسم ليس جزءا من بيانات الـ Blob.
يسمى هذا الأسلوب العنونة بناء على المحتوى (Content Addressing). فالمعرف مشتق من بيانات الـ Object و هو العنوان الذي يستخدمه Git للوصول إليه.
الصورة الحالية
يمكننا الآن تصور طريقة حساب معرف الـ Object:
Object Type + Size + Content
              ↓
          Object ID
لا تقتصر هذه الفكرة على Blobs. يستخدم Git الطريقة نفسها لحساب معرف بقية أنواع الـ Objects.
أصبح لدينا الآن محتوى محفوظ داخل Blob و معرف يقود Git إليه. لكن الـ Blob لا يحمل اسم الملف أو مساره. في الدرس التالي سنرى أين يحفظ Git هذه المعلومات.